


Overview · 프로젝트 소개
제한된 계산 시간 안에서 Hex 게임의 다음 수를 결정하는 탐색 에이전트입니다. Python 연구 환경에서 UCB, 톰슨 샘플링, RAVE-UCB, RAVE-TS의 네 가지 선택 정책을 구현하고, 최종적으로 RAVE 기반 톰슨 샘플링을 사용하는 C++17 탐색 엔진을 구성했습니다.
최종 에이전트는 11 × 11 보드와 300초의 에이전트 계산 예산을 전제로 동작합니다. 알고리즘 선택뿐 아니라 보드 표현, 승리 판정, 메모리 할당, 병렬 처리, 경기 시간 배분까지 다뤘습니다. 저장소에는 Python 연구 코드, Linux용 최종 실행 파일과 소스, Docker 실행 환경, 게임 규칙 테스트, 네 번의 기록 경기 자료가 있습니다.
이 프로젝트는 University of Manchester의 COMP34111 AI & Games 과목 Group 026 팀 프로젝트에서 시작했습니다. 공개 문서에 명시된 개인 기여는 네 Python MCTS 변형 구현·비교, RAVE-TS 방향 선정, Hex 전용 휴리스틱 추가, C++17 이전과 8개 워커 루트 병렬화 주도입니다. 제공된 심판과 팀 소유 프레임워크는 개인 제작물로 소개하지 않습니다.
Problem · 해결하려던 문제
Hex는 같은 색의 돌로 서로 마주 보는 두 변을 연결하는 게임입니다. 11 × 11 보드의 초반에는 선택할 수 있는 칸이 많아, 제한된 시간에 모든 수순을 깊이 탐색하기 어렵습니다. 어떤 수에 계산 시간을 더 쓸지 결정하는 탐색 정책과, 그 시간 동안 수행할 수 있는 시뮬레이션 수가 함께 중요합니다.
이 프로젝트는 두 질문을 다뤘습니다. 첫째, 공통 MCTS 파이프라인에서 자식 노드를 고르는 정책만 바꾸었을 때 어떤 차이가 생기는가? 둘째, Python에서 반복적인 보드 복사와 승리 판정이 계산 부담이 될 때 어떻게 탐색 구현을 구성해야 하는가?
목표는 합법적인 수를 반환하는 것에 더해, 탐색의 불확실성·Hex의 전술 패턴·전체 경기 시간 제한을 한 에이전트 안에서 처리하는 것이었습니다.
Approach · 구현 과정
- 공통 연구 파이프라인 구성:
MCTSBase에 노드 선택, 확장, 무작위 롤아웃, 역전파와 시간 관리 흐름을 구현했습니다. 네 에이전트는 이 기반을 공유하고select_child만 각각 정의합니다. - 선택 정책 비교: 경험적 승률에 탐색 보너스를 더하는 UCB와 베타분포에서 점수를 뽑는 톰슨 샘플링을 구현했습니다. 두 방식에 RAVE 통계를 결합한 변형도 추가했습니다.
- 최종 탐색 방향 선정: 공개 프로젝트 기록은 내부 셀프플레이와 라운드로빈 비교를 바탕으로 RAVE-TS를 선택했다고 설명합니다. 해당 집계 원본은 저장소에 없으므로 이 선정 과정은 과거의 기록으로 구분합니다.
- C++ 핵심 경로 구현: 최종 에이전트의 보드, 트리, 시뮬레이션과 휴리스틱을 C++17로 구현하고, 기존 Python 심판과 표준 입출력으로 연결했습니다.
- 반복 비용과 병렬 처리 개선: 고정 크기 보드 배열, union-find 연결 판정, 워커별 메모리 풀, 8개 독립 루트 탐색을 구성했습니다.
- Hex 전용 판단과 실행 환경 연결: 브리지 방어, 수 정렬, 즉시 승리·차단, 파이 룰과 시간 배분을 추가했습니다. 경기 캡처와 CSV 메타데이터, 실행 방법과 평가 한계를 함께 정리했습니다.
Architecture · 실행 구조
제공된 Python 심판은 경기 규칙과 에이전트 호출을 담당합니다. Python 어댑터가 보드를 직렬화해 C++ 프로세스에 전달하고, C++ 엔진이 선택한 좌표를 받아 심판의 Move 객체로 반환합니다.
Python Hex 심판
        │ 턴 · 보드 · 상대의 수
        ▼
RAVE_TS.py 어댑터
        │ START / CHANGE / SWAP
        ▼
C++17 탐색 엔진
        ├── 즉시 승리·차단 / 오프닝 판단
        └── 8개 독립 루트 워커
              ├── 자체 트리 + 메모리 풀
              ├── RAVE 기반 톰슨 샘플링
              ├── Hex 전용 롤아웃
              └── 루트 자식 방문·승리 통계
                         │
                   워커 결과 합산
                         │ 가장 많이 방문한 수
                         ▼
                     x,y 응답
                         │
                Python Move → 심판
연구 환경과 최종 실행 환경을 함께 보존해 선택 정책의 차이는 Python에서 읽을 수 있고, 최종 시스템의 탐색·병렬화·프로토콜 처리는 C++ 소스에서 확인할 수 있습니다.
Design Decisions · 주요 설계 선택
- 선택 정책만 분리한 연구 구조: 보드 처리, 확장, 롤아웃, 역전파와 시간 배분을 공통으로 유지해 네 정책의 구현 차이를 명확히 했습니다.
- RAVE와 확률적 선택 결합: 직접 방문에서 얻은 통계와 롤아웃에서 얻은 RAVE 통계를 함께 활용했습니다. 최종 C++ 구현은 직접 방문 수가 증가하면 RAVE 혼합 비중을 줄이고, 결합한 승리·패배 통계로 확률적 점수를 샘플링합니다.
- 독립 루트 병렬화: 워커들이 같은 트리를 수정하는 대신 각자 트리와 보드를 갖고 탐색한 뒤 루트 통계를 합칩니다. 탐색 중 공유 트리 잠금이 필요하지 않은 구조를 선택했습니다.
- 점진적 연결 판정: 매 롤아웃마다 전체 보드를 탐색하는 대신, 돌을 놓을 때 인접한 같은 색 돌과 보드 경계를 연결하도록 했습니다.
- 전술 검사와 일반 탐색 결합: 바로 이길 수나 상대의 즉시 승리를 막을 수를 먼저 확인한 뒤 MCTS를 수행합니다. 롤아웃에서는 Hex의 브리지 연결 패턴을 방어합니다.
- 경기 전체 예산 고려: 한 수에 모든 시간을 쓰지 않도록 초반 턴과 남은 예산에 따라 수별 탐색 시간을 정합니다. 제한 시간의 설정과 실제 탐색 처리량은 별도 문제로 다룹니다.
Implementation · 핵심 구현
FastBoard는 121개 칸의 색과 비어 있는 칸 목록을 배열로 관리합니다. make_move는 같은 색의 인접 돌을 union하고, 해당 색의 목표 경계와도 연결합니다. check_win은 양쪽 가상 경계의 대표 루트가 같은지 확인합니다. 빈칸 삭제는 마지막 원소를 삭제 위치로 옮기는 방식으로 처리합니다.
최종 탐색 노드는 방문·승리·RAVE 방문·RAVE 승리를 저장합니다. 자식 선택에서는 직접 통계와 RAVE 통계를 결합하고 두 감마분포의 표본 비율로 베타분포 형태의 점수를 만들어 톰슨 샘플링을 수행합니다. 이 방식은 기록된 승리 횟수가 가장 큰 수만 반복 선택하는 대신 불확실성을 탐색에 반영합니다.
각 워커는 std::pmr::monotonic_buffer_resource와 노드 풀을 소유합니다. 자식 목록과 미확장 수 목록은 워커의 메모리 자원을 이용합니다. std::async로 8개 워커를 실행하고, 모든 future가 끝나면 루트 자식의 방문·승리 통계를 합산합니다. 최종 수는 합산 방문 횟수가 가장 많은 좌표입니다.
추가 휴리스틱은 중앙성과 상대 돌 주변 패턴을 고려한 확장 순서, 위협받은 브리지의 방어, 즉시 승리·차단, hex distance에 따른 후공 스왑 판단입니다. 시간 관리자는 초반에 고정 예산을 사용하고 이후 남은 시간의 비율에 상한을 적용하며, 잔여 시간이 적으면 짧은 예산으로 전환합니다.
어댑터는 보드를 행별 문자열로 만들고 START, CHANGE, SWAP 명령을 C++ 프로세스의 stdin에 보냅니다. stdout의 x,y 응답을 읽어 좌표를 반환하며, -1,-1은 파이 룰의 스왑 요청으로 처리합니다.
Experiments · 정책 비교와 기록 경기
네 Python 에이전트는 같은 연구 파이프라인과 300초의 계산 예산을 공유합니다. UCB·TS는 선택 시 직접 통계를 사용하고, RAVE 변형은 추가 통계를 선택 점수에 반영합니다.
| 변형 | 자식 노드 선택 | RAVE 통계 활용 |
|---|---|---|
| UCB | 경험적 승률 + 탐색 보너스 | 선택 시 미사용 |
| Thompson Sampling | 직접 승리·패배 기반 베타분포 표본 | 선택 시 미사용 |
| RAVE-UCB | 직접 추정과 RAVE 추정을 혼합한 점수 + 탐색 보너스 | 사용 |
| RAVE-TS | 직접·RAVE 카운트를 반영한 베타분포 표본 | 사용 |
현재 공개된 실제 경기 자료는 다음 네 건입니다. 서로 다른 상대와 선공·후공 조건의 개별 기록이며, 반복 토너먼트의 집계 결과가 아닙니다.
| 에이전트 | 상대 | 순서 | 기록 결과 | 종료 턴 |
|---|---|---|---|---|
| RAVE-TS | Davis 7 | 선공 | 승리 | 47 |
| RAVE-TS | Davis 10 | 선공 | 승리 | 33 |
| RAVE-TS | HexHex | 후공 | 패배 | 40 |
| MCTS 기준 모델 | HexHex | 후공 | 패배 | 50 |
저장소의 recorded-matches.csv에는 상대, 순서, 결과, 턴 수와 캡처 경로를 구조화해 보관했습니다. 게임 규칙 테스트는 보드 생성, 합법·불법 수, 색 처리, 타임아웃, 승리 판정과 스왑 규칙을 다룹니다. 이 테스트는 에이전트의 경쟁 성능을 측정한 결과와 구분합니다.
Results · 결과와 구현 성과
이 프로젝트의 주요 성과는 읽기 쉬운 정책 비교 코드에서 실행 가능한 네이티브 병렬 탐색 시스템으로 발전시킨 과정입니다. 네 선택 정책을 공통 구조에서 구현했고, 최종 에이전트에는 C++17, 8개 독립 루트 워커, union-find, 워커별 메모리 자원, 전술 휴리스틱과 시간 관리가 연결되어 있습니다.
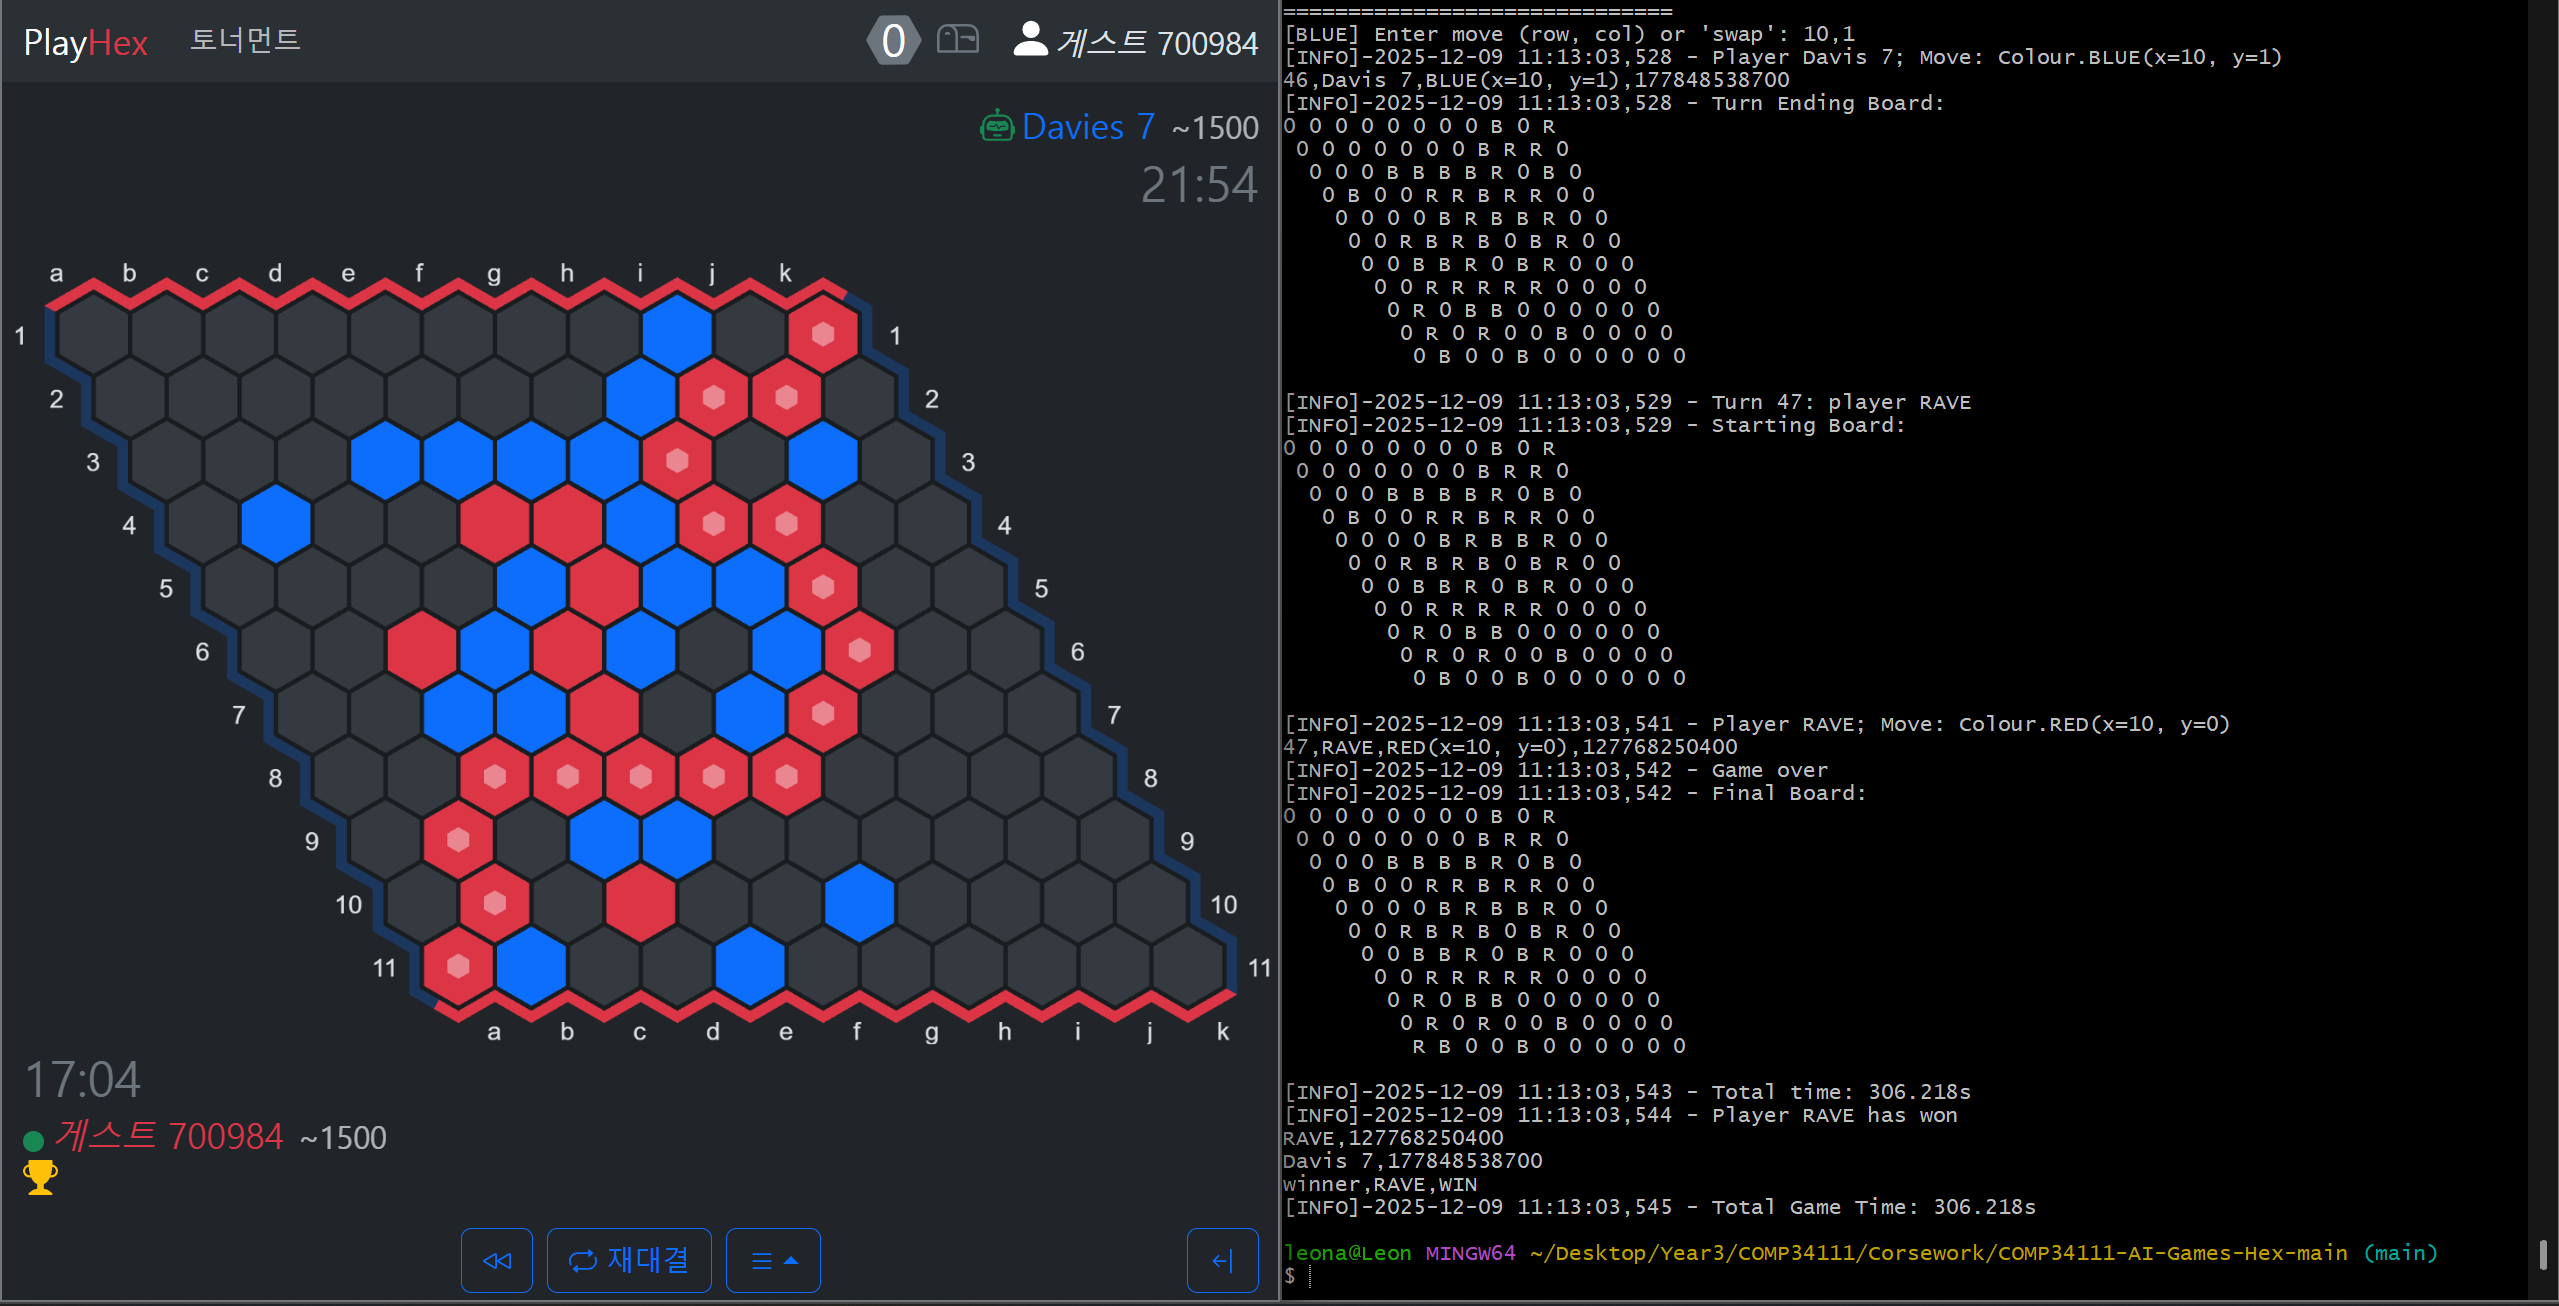
47턴에 종료한 Davis 7 상대 경기의 실제 캡처. 개별 경기에서의 승리를 보여주며 전체 승률을 나타내지는 않습니다.
Davis 7과 Davis 10 상대 승리 기록은 특정 실행에서 에이전트가 승리한 근거입니다. HexHex 상대 패배 기록도 함께 공개해 결과의 범위를 보여줍니다. 8개 워커 구현은 8배 속도 향상의 측정값이 아니며, 현재 자료에는 초당 시뮬레이션 처리량이나 최적화 전후의 정량 벤치마크가 없습니다.
셀프플레이 데이터 생성과 AlphaZero 방식 탐색도 개인 기여로 문서화되어 있습니다. 다만 신경망 실험은 과거 연구 경로이며, 여기서 설명하는 최종 제출 에이전트는 신경망 대신 RAVE 기반 MCTS를 사용하는 CPU 에이전트입니다.
Failure Analysis · 한계와 다음 평가
HexHex와의 후공 경기에서는 RAVE-TS와 MCTS 기준 모델이 모두 패배했습니다. 두 경기는 동일 시드와 동일 오프닝을 사용한 짝지은 실험이 아니므로, 40턴과 50턴의 차이만으로 개선 또는 악화를 판단할 수 없습니다. 패배 원인이 탐색 정책, 오프닝, 롤아웃 휴리스틱 중 무엇인지도 현재 기록만으로 분리하기 어렵습니다.
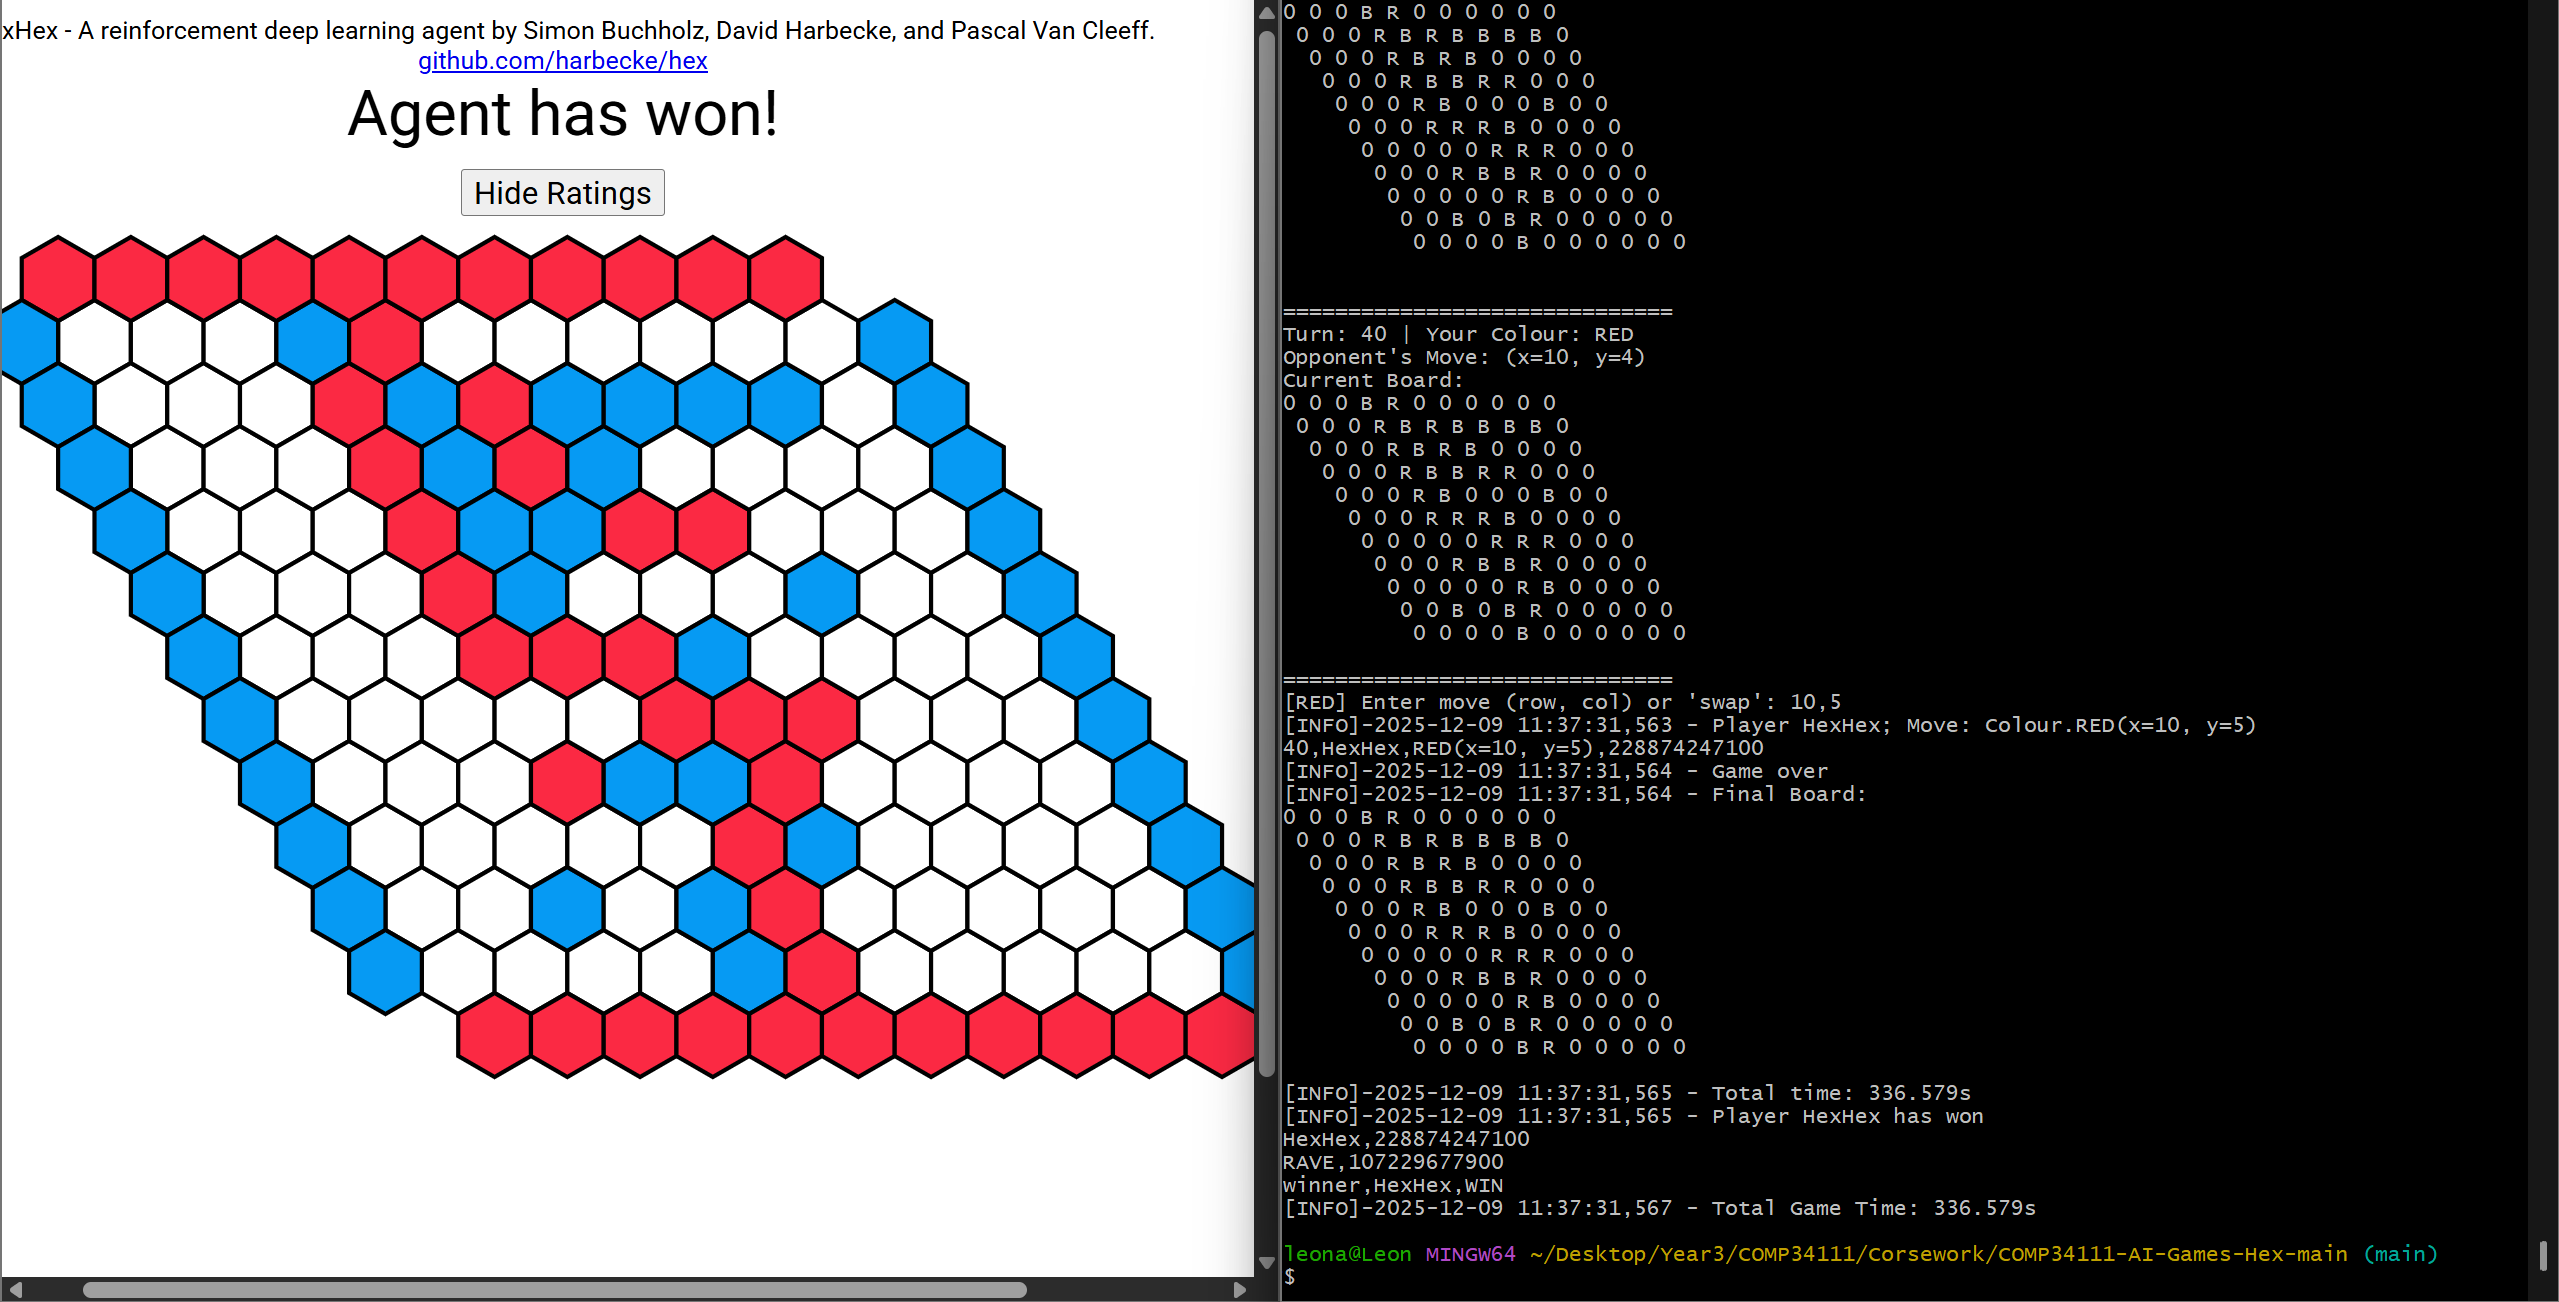
HexHex 상대 후공 패배 기록. 승리 캡처와 함께 개별 경기 결과의 범위를 보여줍니다.
최종 에이전트는 언어 이전, 보드 구조, 병렬 처리와 게임 전략을 함께 바꿨습니다. 어떤 요소가 얼마나 기여했는지 확인하려면 한 요소씩 제거하는 실험이 필요합니다. 루트 병렬화는 공유 트리 잠금 비용을 피하지만 탐색 도중 깊은 노드의 정보를 워커 사이에 공유하지 않으며, 브리지 방어와 수 정렬은 도메인 지식을 주입하는 만큼 탐색 편향도 만들 수 있습니다.
현재 공개 자료에는 내부 토너먼트의 원본 집계 CSV, 고정 난수 시드 목록, 일관된 상대 버전과 하드웨어 정보가 없습니다. 따라서 프로젝트 기록의 RAVE-TS 선정 결론과 네 경기 캡처를 통계적으로 검증된 승률로 확대해 해석하지 않습니다.
후속 평가에서는 색을 번갈아 사용하는 짝지은 경기, 고정 시드, 동일한 시간·CPU 제한을 적용하고 승률의 신뢰구간과 초당 시뮬레이션을 함께 기록해야 합니다. 병렬화·브리지 방어·수 정렬·스왑 휴리스틱을 각각 제거하는 비교도 필요합니다.
Demo · 실행과 결과 확인
Python 연구 에이전트는 Python 3.10 이상에서 외부 패키지 없이 실행할 수 있습니다. 저장소의 engine 폴더에서 다음과 같이 RAVE-TS와 UCB의 경기를 실행합니다.
python Hex.py -b 7 -v -p1 "agents.Group26.Agent_RAVE_TS Agent_RAVE_TS" -p2 "agents.Group26.Agent_UCB Agent_UCB"게임 규칙 테스트도 같은 폴더에서 실행합니다.
python -m unittest discover -s test -v최종 네이티브 실행 파일은 Linux용입니다. deployment의 Docker 안내에 따라 실행 환경을 구성한 뒤, 컨테이너에서 실행 권한을 복원하고 최종 에이전트의 셀프플레이를 실행할 수 있습니다. 최종 RAVE-TS 자체는 CPU에서 동작합니다.
chmod +x agents/Group026/RAVE_TS
python3 Hex.py -p1 "agents.Group026.RAVE_TS RAVE_TS" -p2 "agents.Group026.RAVE_TS RAVE_TS"
기록 경기 갤러리에는 승리와 패배의 원본 캡처를 함께 제공합니다.
Source Code · 코드와 자료
- GitHub 저장소: 프로젝트 소개, 팀 출처와 개인 기여.
- Python MCTS 연구 에이전트: 공통 탐색 파이프라인과 네 선택 정책.
- 최종 C++17 탐색 엔진: 보드 표현, 병렬 탐색, RAVE-TS와 Hex 휴리스틱.
- 아키텍처 설명: 실행 흐름과 엔지니어링 트레이드오프.
- 실험과 경기 메타데이터: 네 경기의 조건과 결과.
- Docker 실행 안내: Linux 배포 환경과 최종 에이전트 실행.