


Overview · 프로젝트 소개
영어 연구 논문을 읽다가 궁금한 내용을 한국어로 질문했을 때, 답과 함께 실제 근거를 바로 확인할 수 있도록 만든 애플리케이션입니다. 텍스트 추출이 가능한 영어 PDF 한 편을 업로드하면 논문의 페이지와 절을 분석하고, 영어 또는 한국어 질문에 답변합니다. 화면에는 답변에 사용한 영어 원문, 페이지 번호, 절 이름, 청크 ID가 나란히 표시됩니다.
이 프로젝트의 중심은 답을 제공하는 과정의 추적 가능성입니다. 영어 답변은 선택한 근거 문장을 추출해 구성하고, 한국어 답변은 그 문장을 로컬 번역 모델로 옮깁니다. 인용은 선택된 원문에서 코드로 조립하며, 근거가 부족한 질문에는 답변을 거절하는 경로를 마련했습니다.
FastAPI 백엔드와 Streamlit 화면을 Docker Compose로 연결한 로컬 포트폴리오 MVP입니다. 검색 실험에 그치지 않고 PDF 업로드, 분석 작업 상태, 질의응답, 원문 확인까지 하나의 사용 흐름으로 구현했습니다.
Problem · 해결하려던 문제
논문 Q&A에서 중요한 것은 답을 원문과 대조할 수 있는지입니다. 전문 용어나 수치가 많은 논문에서는 일부 정보를 빠뜨려도 답변이 자연스럽게 읽힐 수 있습니다. 인용이 붙어 있더라도 실제로 답변을 지지하는 문장인지, 다른 페이지의 내용을 혼합한 것은 아닌지 확인할 수 있어야 합니다.
한국어 질문과 영어 논문 사이의 언어 차이도 검색을 어렵게 합니다. 같은 개념을 서로 다른 표현으로 묻기 때문에 정확한 단어 일치만으로 필요한 문맥을 찾기 어렵고, 의미 검색만 사용하면 논문의 고유 용어를 놓칠 수 있습니다.
이를 해결하기 위해 세 가지 목표를 세웠습니다.
- 한국어와 영어 질문 모두에서 필요한 논문 근거를 찾는다.
- 답변과 인용을 실제 원문 문장까지 추적할 수 있게 한다.
- 논문에 없는 내용을 묻는 질문을 구분하고, 검색 성공과 답변 완전성을 따로 평가한다.
Approach · 해결 과정
먼저 PDF를 페이지별로 읽고 절 경계를 유지한 청크를 생성했습니다. 청크에는 논문 ID, 페이지, 절, 고유 ID를 함께 저장해 이후 검색과 답변 과정에서도 출처가 유지되도록 했습니다. 기본 청크 크기는 1,200자, 중첩은 200자이며, 한 페이지 안에 여러 절이 있으면 절별로 나눕니다.
다음으로 BM25와 다국어 E5 검색기를 결합했습니다. BM25는 전문 용어의 정확한 일치를, 다국어 임베딩은 한국어 질문과 영어 문장의 의미 대응을 담당합니다. 두 검색 결과의 순위를 RRF로 합치고 Cross-Encoder로 재정렬한 뒤, 중복을 줄인 근거를 최대 5개 선택합니다.
마지막으로 검색과 답변 사이에 근거 정책을 두었습니다. 관련도 기준을 통과하지 못하면 답변을 거절합니다. 통과한 경우에는 질문에 맞는 원문 문장을 다시 선택하고, 영어는 추출형 답변으로, 한국어는 NLLB 번역으로 구성합니다. 답변에 원문에 없는 수치가 추가되면 검증에 실패하도록 했으며, 오류 시 안전한 응답을 반환하는 경로도 마련했습니다.
Architecture · 시스템 구조
전체 흐름은 PDF 업로드 → 페이지·절 추출 → 청크 생성 → BM25·다국어 E5 검색 → RRF 결합 → Cross-Encoder 재정렬 → 근거 선택·답변 거절 → 추출 또는 번역 → 답변·원문 인용으로 이어집니다.
| 구성요소 | 역할 |
|---|---|
| Streamlit | PDF 업로드, 분석 상태, 질문 입력, 답변과 원문 근거 표시 |
| FastAPI | 업로드·분석·작업 상태·질의응답·상태 확인 API 제공 |
| PDF 수집 파이프라인 | 페이지 텍스트와 절 추출, 추적 가능한 청크 생성 |
| 검색 파이프라인 | BM25와 다국어 E5 후보 결합, Cross-Encoder 재정렬 |
| 근거·답변 정책 | 근거 중복 제거, 관련도 판단, 문장 선택, 수치 검증 |
| SQLite·로컬 저장소 | 논문 메타데이터, 분석 작업 상태, 논문별 자료와 인덱스 보관 |
| Docker Compose | 백엔드와 UI 실행, 모델 캐시와 업로드 자료의 볼륨 유지 |
사용자가 업로드한 논문별 인덱스와 평가용 코퍼스를 분리했습니다. 애플리케이션은 선택한 논문 한 편 안에서 답을 찾으며, 평가용 논문 코퍼스는 Docker 이미지에 포함하지 않습니다.
Design Decisions · 기술적 판단
서로 다른 검색기의 장점을 결합했습니다. 논문에는 모델명이나 데이터셋명처럼 정확한 단어 일치가 중요한 정보가 있습니다. 동시에 한국어 질문은 영어 원문과 표현이 다릅니다. BM25와 다국어 Dense 검색을 함께 사용하고 RRF로 순위를 합쳐 두 종류의 신호를 활용했습니다.
인용을 답변 모델의 출력에 맡기지 않았습니다. 페이지와 청크 ID는 수집 단계부터 보존하고, 최종 인용은 선택한 원문 문장에서 결정론적으로 조립합니다. 이 구조를 통해 답변에 붙은 인용을 실제 텍스트까지 되짚을 수 있도록 했습니다.
현재 답변 경로는 근거 문장 추출과 번역으로 구성했습니다. 영어 답변은 원문 문장을 사용하고 한국어 답변은 그 문장만 번역합니다. 기존 Qwen 0.5B 생성 경로는 회귀 비교용으로 남겨두었으며 현재 앱의 기본 답변 엔진으로 사용하지 않습니다. 근거를 보존하는 대신 문장 선택의 완전성과 번역 품질이 주요 개선 과제가 됩니다.
검색 성능과 답변 품질을 별도로 측정했습니다. 정답 페이지가 검색 결과 안에 있다고 해서 답변이 질문의 모든 세부사항을 포함하는 것은 아닙니다. 검색 순위, 답변 거절, 인용 지지, 답변 완전성, 실제 API 지연 시간을 분리해 기록했습니다.
모델과 평가를 고정했습니다. 임베딩·재정렬·번역 모델의 리비전을 고정하고, 평가 입력과 결과의 해시를 최종 매니페스트에 남겼습니다. 검색 설정 변경 시 기존 40문항의 Top-5 근거 페이지 재현율이 유지되는지 확인하도록 품질 기준을 정의했습니다.
Implementation · 구현 내용
백엔드는 최대 20 MiB의 PDF 한 편을 받고, 업로드와 분석 요청을 별도 단계로 처리합니다. 분석 작업은 대기·실행·완료·실패 상태를 SQLite에 기록합니다. 직렬 작업 실행과 재시작 시 작업 복구를 구현해, 분석에 시간이 걸려도 사용자가 상태를 확인할 수 있게 했습니다.
PDF 파서는 pypdf를 사용하며 페이지별 원문, 절 이름, 청크 ID를 함께 생성합니다. 논문별 Dense 임베딩 캐시를 저장하고, 준비된 임베딩·재정렬 모델을 재사용하도록 질문 엔진을 구성했습니다. 근거 선택에서는 한 페이지에 후보가 과도하게 몰리거나 거의 같은 문장이 반복되는 것을 줄입니다.
질의응답 단계는 검색 결과, 선택 근거, 답변 거절 판단, 최종 답변을 구분합니다. 원문에 없는 숫자가 답변에 들어갔는지 확인하고, 답변 계약과 인용 참조를 검증합니다. 화면은 질문 언어에 맞는 답변과 실제 사용한 원문만 보여줍니다.
모델 리비전 고정, 로컬 번역, 업로드·분석 API, 질문 API, 오류 처리, UI, 동결 평가 자료를 다루는 회귀 테스트와 검증 명령을 저장소에 포함했습니다. 공개 저장소에 원본 PDF나 모델 캐시가 없어도 Git에 포함된 결과의 무결성과 추적성을 확인할 수 있도록 검증 경로를 나눴습니다.
Experiments · 평가 설계
평가 코퍼스는 영어 논문 30편, 563페이지, 2,463청크로 구성했습니다. 이 중 정확도 평가에는 원문 근거를 검증한 논문 10편의 40문항만 사용했습니다. 질문은 영어 20개와 한국어 20개이며, 나머지 20편은 파싱과 검색 실행의 강건성을 확인하는 자료입니다.
검색 평가는 정답 근거 페이지가 상위 결과 안에 들어오는지와 순위를 측정했습니다. 답변 거절 정책은 답변 가능한 40문항의 유지율, 비근거 보정 질문 10개, 별도 홀드아웃 질문 10개를 나누어 평가했습니다.
답변 품질은 고정 20문항에서 사실·수치·비교·한계 질문을 검토했습니다. 한영 대응 질문이 있어 독립적인 질문 의미는 13개이며, 판정은 어시스턴트 주도 검토입니다. 독립적인 사람 평가로 해석하지 않습니다. 실제 Docker 실행은 논문 3편의 10문항으로 별도 점검했으며, 이 10문항은 한영 대응을 포함한 5개 질문 의미입니다.
최종 결과는 2026년 9월 14일 기준으로 동결하고, 문항별 순위·답변 검토·Docker 응답·입력 해시와 함께 저장했습니다. 평가 범위와 산출물은 저장소 평가 문서에서 확인할 수 있습니다.
Results · 측정 결과
| 지표 | 결과 | 평가 조건 |
|---|---|---|
| 근거 페이지 Recall@1 | 30.0% | 검증된 논문 10편, 40문항 |
| 근거 페이지 Recall@3 | 85.0% | 동일 40문항 |
| 근거 페이지 Recall@5·Recall@10 | 100% | 상위 고유 후보 페이지 안의 Gold 페이지 포함 여부 |
| 전체 MRR | 0.5838 | 영어 20문항과 한국어 20문항 |
| 영어·한국어 MRR | 0.6308 / 0.5367 | 언어별 20문항 |
| 답변 가능한 질문 유지 | 38/40, 95% | 생성 전 답변 거절 정책 |
| 비근거 홀드아웃 질문 거절 | 9/10, 90% | 보정 질문과 분리한 10문항 |
| 고정 답변 검토 | 통과 3 · 부분 통과 14 · 실패 3 | 20문항, 어시스턴트 주도 검토 |
| 인용 지지 실패 | 0건 | 답변이 반환된 18건; 거절 2건은 해당 없음 |
| 추가 논문 파싱·실행 점검 | 20/20 통과 | 정확도 라벨이 없는 확장 논문 |
| 실제 Docker 답변 검토 | 통과 4 · 부분 통과 6 · 실패 0 | 논문 3편의 10문항 |
| Docker API 평균 지연 | 영어 1.47초 · 한국어 11.95초 | CPU 노트북, 언어별 5문항 |
검증 40문항 모두에서 정답 근거 페이지가 상위 5개 고유 후보 페이지 안에 들어왔습니다. 다만 첫 순위 검색은 30%이고, 한국어 질문의 MRR이 영어보다 낮아 상위 순위 품질에는 개선 여지가 남았습니다.
고정 답변 검토에서 통과 또는 부분 통과는 85%지만, 엄격한 통과율은 15%입니다. 따라서 이 값을 답변 정확도 85%로 표현하지 않습니다. 반환한 답변의 인용 지지 실패는 없었으나, 질문이 요구한 수치·목록·비교 정보를 모두 담는 데에는 한계가 있었습니다. CPU API 지연 시간 역시 해당 노트북에서의 측정값이며 모든 환경의 성능을 보장하는 수치는 아닙니다.
Failure Analysis · 실패에서 확인한 점
가장 중요한 발견은 페이지 검색이 성공해도 답변이 완전해지는 것은 아니라는 점입니다. 정답 페이지가 1위인데도 실험의 데이터셋 이름이나 일정 개수를 빠뜨리거나, 질문이 요구한 관계 대신 주변 개념을 설명하는 사례가 있었습니다. 다음 개선의 중심을 검색 페이지 내부의 문장 선택과 근거 범위에 두었습니다.
답변 거절 정책에서도 양방향 오류가 확인됐습니다. 고정 관련도 임곗값 -3.35는 답변 가능한 질문 2개를 거절했고, 논문과 무관한 한국어 홀드아웃 질문 1개는 통과시켰습니다. 후자는 정책 판정까지만 실행한 평가이므로 실제 비근거 답변 생성이 확인된 사례는 아닙니다. 관련도 점수 하나에 의존하는 방식의 한계를 보여줍니다.
한국어 답변에는 근거 범위와 번역 문제가 함께 나타났습니다. 원문에서 선택되지 않은 수치나 파이프라인 이름은 번역 단계에서 복원할 수 없고, 전문 용어와 비교 목록도 어색하게 옮겨질 수 있습니다. 개선 순서는 근거 선택 범위를 보완한 뒤 고유명사·수치·목록이 번역 후에도 유지되는지 확인하는 것입니다.
실제 Docker 10문항에서는 모든 반환 인용이 답변을 지지했지만, 미리 지정한 Gold 페이지와 정확히 일치한 경우는 4건이었습니다. 같은 사실을 지지하는 다른 페이지를 인용하는 경우도 있으므로, 인용 지지와 Gold 페이지 일치를 같은 지표로 취급하지 않았습니다.
향후 과제는 다중 신호를 활용한 답변 거절 정책, 질문 유형별 문장 선택, 인접 근거 결합, 번역 시 고유명사와 비교 항목 보존입니다. 이 항목들은 개선 계획이며 이미 측정된 성능 향상으로 주장하지 않습니다. 스캔 PDF와 OCR, 표·그림의 시각적 해석, 신뢰할 수 있는 수식 해석, 여러 논문 비교는 현재 MVP의 지원 범위에서 제외했습니다.
Demo · 실제 화면과 실행 방법
아래는 영어 논문에 한국어로 질문하고 답변 옆에서 원문 근거를 확인하는 실제 실행 화면입니다.
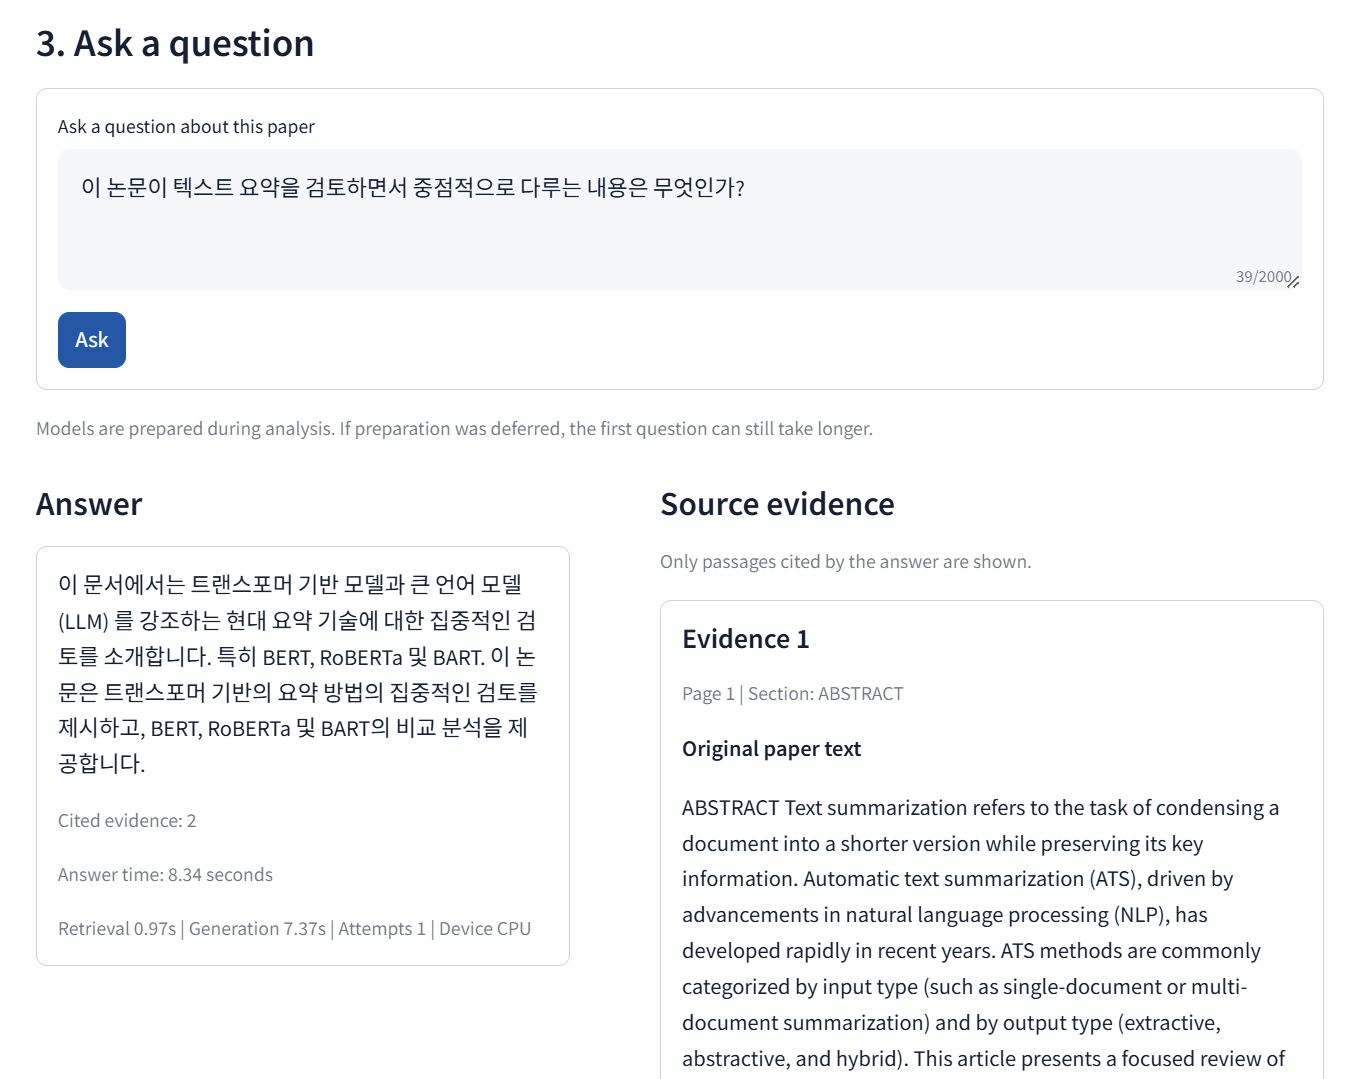
직접 실행하려면 저장소를 내려받고 Docker Desktop이 실행된 환경에서 프로젝트 루트의 다음 명령을 사용합니다.
docker compose up --build -d실행 후 브라우저에서 로컬 UI 주소 http://127.0.0.1:8501을 열고, 텍스트 기반 영어 PDF 한 편을 업로드합니다. 분석이 완료되면 영어 또는 한국어로 질문하고 답변과 인용 원문을 확인할 수 있습니다. API 문서는 http://127.0.0.1:8000/docs에서 제공합니다.
최초 분석에는 모델 다운로드와 초기화 시간이 필요합니다. 이후 실행에서는 Docker 볼륨에 저장된 모델과 업로드 자료를 재사용합니다. 실행 준비와 설정은 Docker 실행 안내에 정리했습니다. 현재 제공 형태는 로컬 데모입니다.
Source Code · 코드와 검증 자료
기능, 실행 화면, 환경 설정과 지원 범위는 GitHub 저장소에서 확인할 수 있습니다. 데이터 수집부터 검색·답변까지의 구성은 아키텍처 문서에, 지표의 조건과 해시 매니페스트는 최종 평가 자료에 남겼습니다.
대표적인 오답·부분 답변과 다음 개선 방향은 실패 사례 분석에서 공개합니다. 저장소의 python -B scripts/verify_project.py 명령은 현재 회귀 테스트와 Git에 포함된 데이터 무결성, 원문 추적성, 검토 답변 및 Docker 증거를 검증합니다.