


Overview · 프로젝트 소개
영어 글 두 편을 입력받아 동일 저자 또는 다른 저자 라벨을 분류하는 프로젝트입니다. Dongmyung Park과 Juho Kim이 함께 개발했으며, 문체를 직접 수치화한 머신러닝 모델과 문맥을 학습하는 Transformer 모델을 같은 제공 데이터에서 비교했습니다.
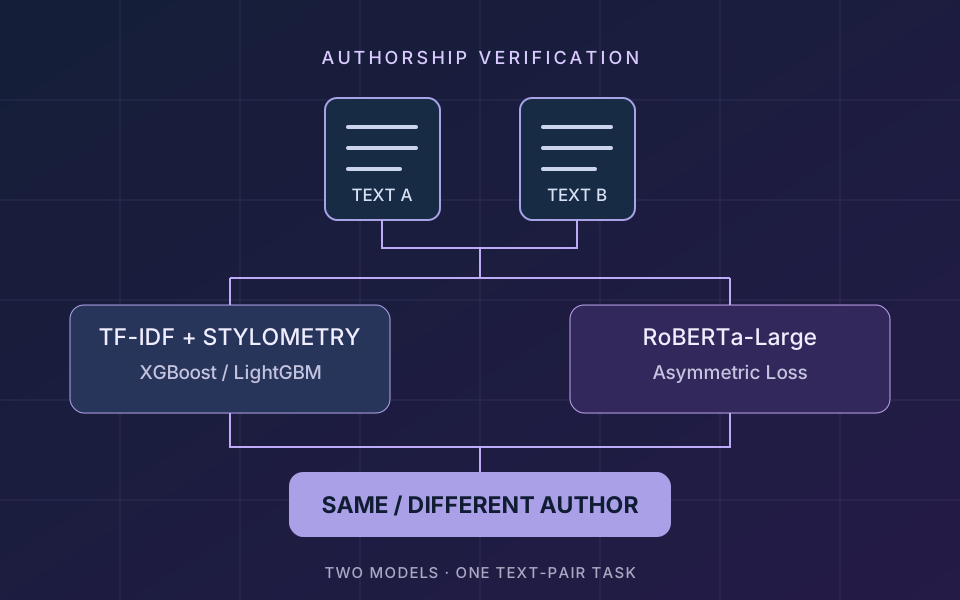
첫 번째 모델은 단어·문자·기능어 TF-IDF와 24개 문체 특징을 사용하는 XGBoost·LightGBM 앙상블입니다. 두 번째 모델은 영어 글 쌍을 함께 읽는 RoBERTa-Large를 Asymmetric Loss로 파인튜닝한 모델입니다. 작은 CPU 모델과 큰 문맥 모델 사이의 성능·저장 용량·연산 비용을 비교할 수 있도록 두 경로를 보존했습니다.
저장소에는 학습·추론 노트북, 데이터, 라벨 없는 테스트 예측, 모델 카드, 재현 안내와 공통 CLI를 포함했습니다. 학습 결과를 다른 입력에서 시험하고, 기록된 개발 성능의 조건과 한계를 확인할 수 있도록 실행 자료와 평가 설명을 함께 제공합니다.
Problem · 해결하려던 문제
글의 주제가 비슷해도 저자는 다를 수 있고, 같은 저자가 쓴 글이라도 소재가 달라지면 단어 사용이 크게 달라질 수 있습니다. 단어 중복뿐 아니라 문장 길이, 구두점, 기능어와 표현 습관 같은 신호를 함께 표현하는 것이 과제였습니다.
이메일 주소나 URL처럼 글의 내용 외부에서 저자를 드러내는 정보가 있으면 모델이 단순한 표식을 학습할 수 있습니다. 두 파이프라인에서 식별성 메타데이터를 정리한 뒤 텍스트 표현을 구성했습니다.
학습한 판별기가 새 글에서도 같은 성능을 보이는지 판단하는 일도 중요합니다. 개발 세트에서 좋은 점수를 얻더라도 데이터 중복, 모델 선택, 글 길이와 장르 차이가 결과에 영향을 줄 수 있습니다. 모델 비교와 함께 평가 범위를 확인하고, 공개 수치를 어디까지 해석할 수 있는지 정리했습니다.
Approach · 두 모델의 구현 과정
문체 모델에서는 먼저 각 글을 단어·문자 n-gram과 기능어 TF-IDF로 표현했습니다. 문장 길이, 구두점, 대문자 사용, 어휘 다양성, 접미사 패턴 등 24개 특징을 추가하고, 두 글의 특징 차이·곱·비율·평균·코사인 거리를 조합해 쌍 단위 입력을 만들었습니다.
이 입력으로 XGBoost와 LightGBM을 학습한 뒤 개발 세트에서 가중치와 분류 임계값을 탐색했습니다. 최종 설정은 XGBoost 0.26, LightGBM 0.74의 가중 결합이며, 동일 저자 판정 임계값은 0.43입니다.
Transformer 경로에서는 이메일 헤더·주소·URL을 정리하고 두 글을 RoBERTa의 텍스트 쌍 형식으로 인코딩했습니다. 최대 입력은 두 글을 합쳐 512토큰이며, 더 긴 입력은 longest_first 방식으로 잘립니다. RoBERTa-Large에 이진 분류 헤드를 두고 Asymmetric Loss로 파인튜닝했으며, 개발 세트에서 선택한 임계값은 0.51입니다.
학습 뒤에는 두 모델을 공통 터미널 도구에 연결했습니다. 사용자가 영어 글 두 편을 입력하고 모델을 선택하면, 판별 결과·모델 점수·저장된 임계값을 같은 형식으로 볼 수 있습니다.
Architecture · 시스템 구조
두 경로는 같은 영어 글 쌍을 입력받지만, 중간 표현을 다르게 구성합니다.
| 경로 | 입력 처리 | 표현·모델 | 최종 판단 |
|---|---|---|---|
| 문체 앙상블 | 이메일·URL·날짜·전화번호·반복 문자와 공백 정리 | 단어·문자·기능어 TF-IDF + 문체 특징 → XGBoost·LightGBM | 두 출력의 가중 결합, 임계값 0.43 |
| RoBERTa | 이메일 헤더·주소·URL과 공백 정리 | 두 글을 합친 최대 512토큰 → RoBERTa-Large 이진 분류 | 클래스 1 점수, 임계값 0.51 |
학습 노트북은 모델·벡터라이저·토크나이저·임계값을 저장하고, 추론 도구는 같은 파일을 읽습니다. 학습과 실행에서 다른 전처리를 적용하지 않도록 각 경로의 텍스트 정리와 특징 생성 방식을 맞췄습니다.
verify_author.py는 모델 선택, 모델 폴더 확인, 입력 수집, CPU·CUDA 선택, 결과 출력을 담당합니다. 모델 파일은 용량 때문에 Git에서 제외했고, 다운로드 위치와 필요한 파일 목록을 README에 정리했습니다. 저장소의 테스트 예측 CSV는 정답 없는 데이터에 대한 출력 자료입니다.
Design Decisions · 기술적 판단
직접 설계한 문체 표현과 사전학습 문맥 표현을 함께 비교했습니다. TF-IDF와 문체 특징은 어떤 입력 신호를 사용하는지 살펴보기 쉽고 CPU에서 실행할 수 있습니다. RoBERTa는 두 글의 문맥을 함께 처리하지만 더 큰 모델과 연산 자원을 요구합니다. 두 경로를 유지해 구현 방식의 차이와 실제 비용을 비교했습니다.
Asymmetric Loss의 클래스별 가중치를 구분했습니다. RoBERTa에는 음성 클래스 gamma_neg=2, 양성 클래스 gamma_pos=1을 적용했습니다. 각 클래스의 쉬운 예제가 손실에 미치는 영향을 다르게 줄이는 학습 설계이며, 이 설정의 효과를 새로운 도메인에서 검증했다고 주장하지 않습니다.
최종 판단에는 개발 세트에서 선택한 임계값을 사용했습니다. 두 모델에 동일한 0.5를 일괄 적용하는 대신 Macro F1을 기준으로 경계를 탐색했습니다. 문체 앙상블의 결합 가중치도 함께 선택했습니다. 이 선택에 사용한 데이터에서 성능을 보고한다는 점을 평가 해석에 포함했습니다.
성능 수치와 모델 비용을 함께 공개했습니다. 문체 모델 파일은 60MB 미만이고 CPU 추론을 지원합니다. RoBERTa-Large는 약 3억 5,500만 파라미터와 1.32GB 가중치를 사용합니다. 더 높은 개발 점수만으로 모든 실행 환경에서 같은 선택이 적합하다고 판단하지 않았습니다.
데이터 중복과 짧은 입력을 추가로 분석했습니다. 학습·개발 CSV를 대조하고, 저장한 RoBERTa 모델을 같은 개발 세트의 길이·중복 조건별로 다시 평가했습니다. 원래 수치와 사후 부분집합 분석을 구분해 일반화에 관한 과도한 해석을 줄였습니다.
Implementation · 학습과 추론 도구
문체 경로의 단어 1–2 gram과 문자 2–4 gram TF-IDF는 각각 최대 7,000개 특징을 사용합니다. 기능어는 고정 영어 어휘로 표현하며, 문체 특징은 글의 길이와 표기 습관을 보완합니다. 쌍의 두 글을 각각 벡터화한 뒤 차이와 유사성 특징을 계산해 분류기에 넣습니다.
XGBoost와 LightGBM에는 조기 종료를 적용하고, 학습한 분류기와 벡터라이저를 함께 저장했습니다. 추론에서는 새로운 글에 벡터라이저를 다시 학습하지 않고 저장한 어휘와 변환을 사용합니다. 가중치와 임계값도 설정 파일에서 불러옵니다.
RoBERTa는 학습률 5e-6, 학습 배치 32, Warmup ratio 0.1, Weight decay 0.01 설정으로 학습했습니다. 최대 14 epoch 설정에서 13번째 epoch에 조기 종료했으며, 개발 세트에서 선택한 체크포인트와 임계값을 추론에 사용합니다.
CLI는 필수 모델 파일이 있는지 검사하고, 기본 모델 폴더와 원래 다운로드 폴더 이름을 모두 지원합니다. 두 입력을 명령행 인자로 함께 전달하거나 대화형으로 입력할 수 있습니다. RoBERTa에서는 CUDA 사용 여부를 확인하며, NVIDIA GPU가 감지됐지만 PyTorch가 CUDA를 사용할 수 없는 경우 환경 안내를 제공합니다.
출력의 Same-author probability는 보정되지 않은 모델 점수입니다. 문체 모델은 앙상블 점수, RoBERTa는 클래스 1 softmax 점수를 표시합니다. 이 값이 실제로 같은 저자일 확률이나 사람의 신원을 증명하는 값은 아닙니다.
Experiments · 평가 데이터와 범위
학습 데이터는 영어 글 쌍 27,643개, 라벨이 있는 개발 데이터는 5,993개입니다. 개발 세트는 서로 다른 저자 2,937쌍과 동일 저자 3,056쌍으로 구성됩니다. 별도의 테스트 5,985쌍과 예시 20쌍에는 라벨이 없습니다.
두 모델의 공개 지표는 동일한 제공 개발 세트에서 얻었습니다. 이 세트는 분류 임계값, 앙상블 가중치, 조기 종료와 RoBERTa 체크포인트 선택에도 사용됐습니다. 독립적인 최종 테스트 세트 결과로 해석하지 않습니다.
CSV를 비교한 결과 개발 세트 630쌍, 약 10.5%가 학습 세트의 글 쌍과 순서까지 완전히 같았고 라벨도 일치했습니다. 데이터에는 글과 쌍 라벨만 있으며 저자 ID나 도메인 라벨이 없어, 이 자료만으로 저자·도메인이 분리된 평가인지 확인할 수 없습니다.
추가 분석에서는 저장한 RoBERTa 체크포인트, 원래 전처리, 임계값 0.51로 같은 개발 세트를 재평가했습니다. 글 길이와 정확한 학습 쌍 중복 여부를 나누어 성능을 확인했으며, 중복을 제외한 결과도 같은 개발 세트의 사후 부분집합 분석입니다.
Results · 기록된 개발 결과
| 모델 | 개발 Macro F1 | 동일 저자 F1 | 개발 정확도 | 모델 파일·추론 |
|---|---|---|---|---|
| 문체 XGBoost·LightGBM 앙상블 | 0.7702 | 0.7813 | 약 0.77 | 파일 60MB 미만, CPU 지원 |
| RoBERTa-Large + Asymmetric Loss | 0.8348 | 0.8365 | 약 0.83 | 가중치 약 1.32GB, CUDA 권장 |
제공된 개발 세트에서는 RoBERTa의 Macro F1이 문체 앙상블보다 0.0646 높았습니다. 이 비교에는 개발 데이터의 학습 중복과 모델 선택 조건이 포함되며, 새 저자·장르·도메인의 성능을 나타내지 않습니다.
| RoBERTa 사후 개발 부분집합 | 쌍 수 | Macro F1 |
|---|---|---|
| 두 글 합계 50단어 이하 | 554 | 0.6680 |
| 두 글 합계 100단어 초과 | 4,775 | 0.8599 |
| 학습 세트와 글 쌍이 정확히 동일 | 630 | 0.9857 |
| 정확한 학습 쌍 중복을 제외 | 5,363 | 0.8170 |
단어 수는 공백 기준으로 계산했습니다. 길이 조건과 중복 조건은 서로 겹칠 수 있어 이 표는 전체 데이터를 서로 배타적으로 나눈 표가 아닙니다. 중복 제외 Macro F1 0.8170도 독립적인 held-out 성능이 아닙니다.
문체 모델의 기록된 학습 시간은 약 1시간 10분, RoBERTa는 약 6시간 11분입니다. 전자는 T4 GPU 2개와 멀티코어 CPU 환경, 후자는 A100 40GB GPU 1개 환경에서 기록했습니다. 서로 다른 하드웨어의 실행 기록이므로 시간만으로 공정한 학습 효율 비교를 하지는 않습니다.
Failure Analysis · 무엇이 결과를 제한했는가
가장 큰 평가 제한은 학습·개발 중복입니다. 정확히 같은 쌍에서는 RoBERTa Macro F1이 0.9857이었고, 중복을 제외한 같은 개발 부분집합에서는 0.8170이었습니다. 공개 점수만 보면 드러나지 않는 데이터 조건의 영향을 확인했습니다. 저자와 도메인을 분리한 새로운 라벨 데이터로 평가하는 작업이 남아 있습니다.
짧은 글에서도 결과가 약해졌습니다. 두 글 합계 50단어 이하의 Macro F1 0.6680은 100단어 초과 부분집합의 0.8599보다 낮았습니다. 학습 데이터 글 길이 중앙값은 약 123단어이므로, 매우 짧은 터미널 예시의 높은 점수를 그대로 신뢰할 수 없습니다.
모델별 입력 제약도 다릅니다. 문체 모델은 학습한 TF-IDF 어휘 밖의 표현을 충분히 담지 못하고, RoBERTa는 두 글을 합쳐 512토큰을 넘으면 일부를 잘라냅니다. 익숙하지 않은 장르, 다른 언어, 코드 스위칭에서의 성능은 측정하지 않았습니다.
공동 발표 포스터에는 도메인 변화에 따른 과적합 감소라는 역사적 설명이 있지만, 별도 도메인 분리 평가로 검증된 주장은 아닙니다. 현재 프로젝트 소개에서는 최신 모델 카드의 평가 범위를 따릅니다.
이 경험에서 얻은 핵심은 모델 구조뿐 아니라 데이터 분할과 입력 조건을 함께 설명해야 결과를 평가할 수 있다는 점입니다. 임계값 선택, 중복, 글 길이, 계산 비용을 공개해 기록된 실험과 아직 확인하지 못한 일반화 성능을 구분했습니다.
Demo · 공동 프로젝트 자료와 직접 실행
아래는 현재 코드의 문체 앙상블과 RoBERTa 추론 경로를 정리한 구조도입니다. 두 모델이 같은 글 쌍을 어떤 표현과 분류 단계로 처리하는지 보여줍니다.
공동 발표 포스터는 당시 발표 자료로 보존했습니다. 포스터의 도메인 변화에 따른 과적합 감소 설명은 독립적인 도메인 분리 평가로 확인되지 않았으며, 현재 성능의 측정 근거로 사용하지 않습니다.

저장소의 모델 다운로드 안내에 따라 필요한 파일을 준비하고, Python 3.12 환경에서 실행합니다. 문체 모델은 CPU에서 사용할 수 있습니다.
python -m pip install -r requirements-inference.txt
python verify_author.py --model stylometric
두 영어 글을 입력하면 동일 저자·다른 저자 판별, 모델 점수, 분류 임계값이 출력됩니다. RoBERTa를 선택하려면 다음 명령을 사용하며, 이 예시는 CUDA 지원 PyTorch와 GPU가 준비된 환경을 전제로 합니다.
python verify_author.py --model roberta --device cuda--text-1과 --text-2로 두 글을 직접 전달하거나, --model-dir로 모델 파일 위치를 지정할 수 있습니다. 모델 파일의 정확한 위치와 CPU 실행 옵션은 재현 안내에 정리했습니다. 현재 제공 형태는 로컬 터미널과 노트북 데모입니다.
Source Code · 코드와 평가 근거
GitHub 저장소에서 공동 프로젝트의 데이터, 학습·추론 노트북과 CLI를 확인할 수 있습니다. 두 파이프라인의 세부 설계와 측정 조건은 문체 앙상블 모델 카드, RoBERTa 모델 카드에 공개했습니다.
라벨 없는 테스트 데이터의 예측은 results에 보존했으며, 그 파일을 테스트 정확도나 F1로 표현하지 않습니다. 새로운 입력을 시험하는 방법과 저장된 모델로 개발 결과를 확인하는 절차는 재현 안내에서 제공합니다.