


Overview · 프로젝트 소개
한국어 질문에 필요한 근거를 찾기 위해 모델 학습과 검색 파이프라인을 단계별로 구축한 프로젝트입니다. 4주 동안 KLUE-RoBERTa 분류 모델, 문장 임베딩 Retriever, 질문과 문맥을 함께 읽는 Cross-Encoder Reranker를 실험한 뒤, 저장한 모델을 실제 로컬 Python 코드로 연결했습니다.
최종 시스템은 KorQuAD의 한국어 문맥에서 근거를 검색하고 QA Reader로 답 구간을 추출합니다. 터미널에는 답변, 출처 제목, 청크 ID와 근거가 함께 출력됩니다. 인터넷 검색이나 사용자 문서 업로드 없이, 저장된 지식베이스 안에서 사실을 찾는 형태입니다.
이 프로젝트의 초점은 한국어 표현 학습에서 실제 검색으로 이어지는 과정입니다. 직접 학습한 임베딩과 재정렬 모델의 역할을 나누고, BM25·Dense·Hybrid·Reranker를 동일한 평가 범위에서 비교했습니다. 생성형 Qwen 답변과 추출형 Reader의 차이도 실험 기록으로 남겼습니다.
Problem · 해결하려던 문제
질문의 핵심 단어가 문맥에 그대로 있더라도 답 구간이 가까이 있지 않을 수 있고, 같은 의미를 다른 표현으로 묻는 질문에서는 단어 일치만으로 충분한 근거를 찾기 어렵습니다. 검색 결과 중 답이 있는 문맥을 찾는 문제와, 그 문맥을 상위에 올리는 문제를 분리할 필요가 있었습니다.
문장 유사도 데이터에서 임베딩을 잘 학습했다고 해서 실제 질문·문맥 검색에서도 같은 성능을 얻는 것은 아닙니다. 질문과 긴 위키백과 문맥 사이에는 입력 형태와 과업의 차이가 있으므로, 학습한 모델을 KorQuAD 검색에 연결한 뒤 다시 평가했습니다.
또한 관련 문맥을 찾았다는 사실만으로 답변의 정확성을 보장할 수 없습니다. Reader가 엉뚱한 문자열을 추출하거나, 질문에 없는 전제를 무시한 채 날짜 같은 정보를 반환할 수 있습니다. 검색·재정렬·추출·답변 보류를 각각 확인할 수 있는 구조가 필요했습니다.
Approach · 4주간의 개발 과정
| 단계 | 구현·실험 | 다음 단계에 전달한 결과 |
|---|---|---|
| 1주차 | KLUE-YNAT 뉴스 제목 분류, 학습률·입력 길이·시드 설정 비교 | Transformer 학습·평가 경험과 분류 실험 기록 |
| 2주차 | KLUE-STS 문장 임베딩 학습, Contrastive 학습, Hard Negative 추가 학습, FAISS 검색 | Retriever 체크포인트·토크나이저·검색 후보 |
| 3주차 | 질문·문맥 쌍 Cross-Encoder 학습, 상위 후보 재정렬 | 최종 Reranker 체크포인트와 순위 평가 |
| 4주차 | BM25와 Dense 검색의 RRF 결합, Qwen·Reader 답변 비교, 인용·오류 분석 | 지식베이스·인덱스·평가 결과·로컬 실행 코드 |
1주차 분류 모델은 검색기에 연결하지 않았습니다. 이후 검색을 구성하는 핵심 학습 결과는 2주차 Retriever와 3주차 Reranker입니다.
2주차에는 KLUE-RoBERTa의 토큰 표현을 마스킹 평균 풀링하고 정규화해 문장 벡터를 만들었습니다. 문장 유사도 학습과 Contrastive 학습으로 표현을 조정한 뒤, 구분하기 어려운 부정 쌍을 추가해 실험했습니다. 3주차에는 Retriever가 넓게 확보한 후보 안에서 정답 문맥의 순위를 높이는 모델을 학습했습니다.
4주차에는 두 검색 방식의 장점을 함께 사용했습니다. BM25와 Dense가 각각 상위 50개를 찾고, RRF로 합친 상위 20개를 Reranker가 재정렬합니다. 최종 상위 3개 문맥에서 Reader가 답을 추출하거나, 근거·점수 조건에 따라 답변을 보류합니다.
Architecture · 시스템 구조
현재 로컬 앱의 흐름은 한국어 질문 → BM25 Top-50 + 학습한 Dense·FAISS Top-50 → RRF Top-20 → 학습한 Cross-Encoder Top-3 → QA Reader → 답변·인용 또는 답변 보류입니다.
| 구성요소 | 역할 |
|---|---|
| KLUE-RoBERTa Retriever | 질문과 문맥을 같은 벡터 공간으로 표현 |
| FAISS | 저장된 문맥 임베딩에서 Dense 후보 검색 |
| BM25 | 질문의 단어와 근거 문맥 사이의 어휘 일치 검색 |
| RRF | 두 검색기의 순위를 결합해 재정렬 후보 생성 |
| Cross-Encoder Reranker | 질문과 후보 문맥을 함께 읽어 최종 순위 결정 |
| koELECTRA QA Reader | 문맥 안에서 답의 시작·끝 구간 추출 |
| 답변 정책·CLI | 후보 점수·연도·답 문자열 검사를 적용하고 결과 출력 |
지식베이스는 KorQuAD 1.0 validation split의 위키백과 문맥 960개를 나눈 5,889개 청크입니다. 각 청크의 행 순서와 ID가 FAISS 인덱스·BM25 코퍼스와 맞는지 확인하고, 모델 차원과 인덱스 차원도 검증합니다.
Design Decisions · 기술적 판단
Retriever와 Reranker의 역할을 나눴습니다. Retriever는 많은 문맥 중 후보를 빠르게 확보하고, Cross-Encoder는 줄어든 후보를 질문과 함께 읽습니다. 재정렬은 후보 집합을 늘리지 않으므로 상위 20개 재현율과 첫 순위 품질을 구분해 평가했습니다.
단어 일치와 의미 검색을 순위로 결합했습니다. 4주차 실험에서는 BM25가 첫 순위에서, Dense가 넓은 후보 범위에서 상대적으로 강했습니다. 두 모델의 원시 점수를 직접 같은 척도로 취급하기보다 RRF로 순위를 합친 뒤 재정렬했습니다.
생성형 답변과 추출형 답변을 비교한 뒤 현재 앱에는 Reader를 연결했습니다. 노트북에서는 Qwen 생성과 검증 조건을 비교했지만, 로컬 CLI는 QA Reader만 사용합니다. Reader의 답 문자열이 실제 문맥에 있는지 검사하고, 출처를 답을 추출한 청크에 연결합니다. 생성 모델로 문장을 자유롭게 만드는 경로와는 다른 판단입니다.
답을 보류하는 판단을 후보별로 적용했습니다. 기본 기준은 RRF 0.025, Reranker 0.50, Reader 0.10입니다. 빈 답이 더 높게 평가되는 경우, 답 문자열이 인용 문맥에 없는 경우, 질문에 명시한 네 자리 연도가 문맥에 없는 경우도 제외합니다. 이 점수들은 정답 확률로 보정된 값이 아닙니다.
실험 결과와 후처리를 구분했습니다. 저장된 답변을 바꾸지 않고 인용 계산만 수정한 작업에는 후처리 메타데이터와 해시를 남겼습니다. 인용률 증가를 모델 정확도 개선이나 새 GPU 추론 결과로 표현하지 않았습니다.
Implementation · 로컬 앱으로 연결한 내용
학습·실험 노트북과 재사용 가능한 실행 코드를 분리했습니다. korean_rag 패키지는 모델 파일 로딩, BM25·FAISS 검색, 재정렬, Reader 추출, 답변 정책, CLI와 평가를 담당합니다. 노트북 재학습 없이 저장된 Retriever와 Reranker를 불러와 질문할 수 있습니다.
Retriever는 저장된 체크포인트의 구조와 가중치를 복원하고, 토크나이저와 함께 로컬에서 실행합니다. 검색 결과에는 청크 ID, 제목, 문맥, RRF와 재정렬 점수를 남겨 각 단계의 결과를 확인할 수 있게 했습니다.
Reader의 답 구간 선택에서는 문맥 토큰과 빈 답을 함께 비교합니다. 시작·끝 위치가 실제 문맥에 있는지, 구간 길이가 유효한지 확인하고, 조건을 만족한 후보 중 높은 점수의 답을 선택합니다. 최종 응답은 답변 반환과 보류를 구분해 출력합니다.
질문은 앞뒤 공백을 제외하고 1,000자 이내, 토크나이저 기준 128토큰 이내로 제한합니다. 길이를 임의로 잘라 질문의 의미를 바꾸는 대신 입력을 줄여 달라는 메시지를 제공합니다. CPU·CUDA 선택, JSON 출력, 검색 결과만 확인하는 옵션, 다른 모델 출력물 경로도 CLI에서 지원합니다.
모델 없이 실행하는 회귀 테스트와 실제 모델로 수행하는 추론 평가를 분리했습니다. 모델 출력물이 없는 환경에서는 해당 아티팩트 검사를 건너뛰며, 실제 추론 평가에서는 100개 질문의 답변과 무응답 점검 결과를 JSON으로 저장합니다.
Experiments · 단계별 검증
2주차에는 KLUE-STS 기반 제어된 검색 평가에서 사전학습 임베딩과 학습 후 임베딩을 비교했습니다. 선택한 최종 모델의 Recall@1은 0.9500, Pearson은 0.8519, Spearman은 0.8703입니다. 이 수치를 KorQuAD 전체 검색 성능과 혼합하지 않았습니다.
Hard Negative의 다중 시드 비교는 같은 3일차 모델에서 시작해 152쌍의 추가 학습을 반복한 실험입니다. 전체 학습을 시드별로 처음부터 반복한 결과는 아닙니다. 선택한 시드 378의 결과와 실험 범위를 2주차 보고서에 기록했습니다.
3주차에는 후보 재정렬에 따른 검색 순위 변화를 확인했습니다. 해당 평가에서 Dense Recall@1 0.4610은 재정렬 후 0.7520으로, MRR@10 0.5437은 0.7796으로 바뀌었습니다. Top-20 Recall은 같은 후보 집합을 재정렬하므로 0.8180으로 유지됐습니다.
최종 4주차 검색 비교는 고정 1,000문항, 답변 비교는 그중 고정 100문항으로 수행했습니다. 개발에 사용했던 표본이므로 새로운 held-out 성능이 아닙니다. 로컬 CLI는 별도 답변 정책을 적용해 다시 실행했으며, 노트북과 로컬 앱의 지표를 구분해 저장했습니다.
Results · 측정 결과
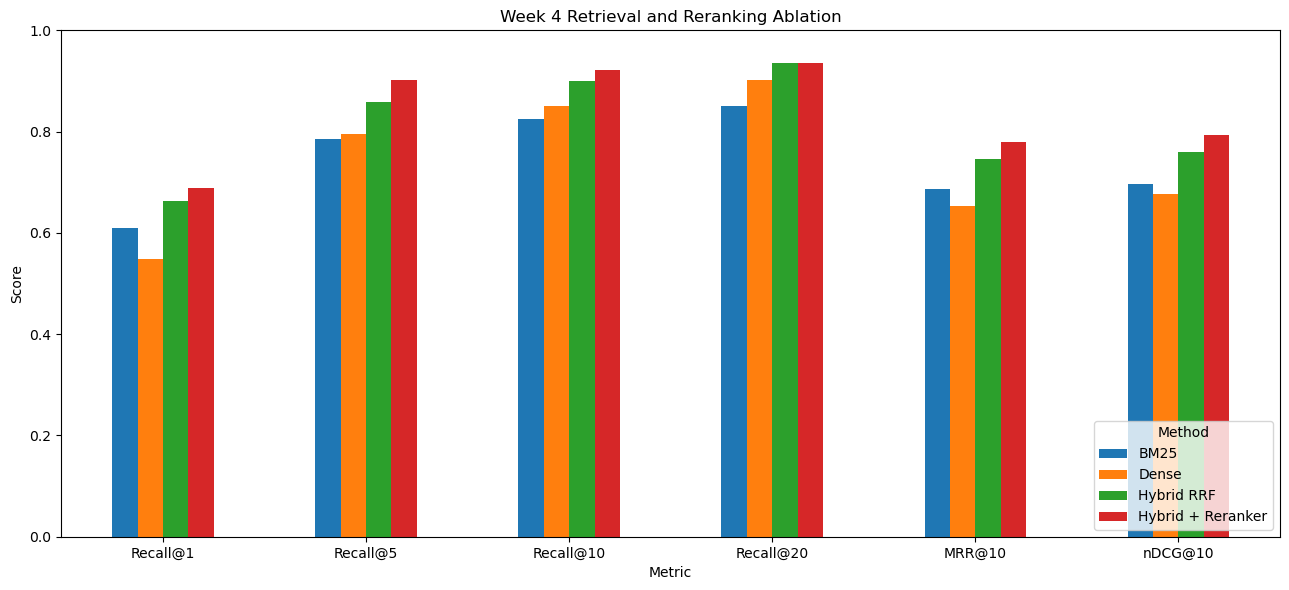
다음 표는 4주차의 동일한 고정 검색 1,000문항에서 측정한 결과입니다.
| 검색 방법 | Recall@1 | Recall@5 | Recall@20 | MRR@10 |
|---|---|---|---|---|
| BM25 | 60.9% | 78.6% | 85.1% | 0.6870 |
| Dense | 54.9% | 79.5% | 90.1% | 0.6535 |
| Hybrid RRF | 66.2% | 85.9% | 93.5% | 0.7452 |
| Hybrid RRF + Reranker | 68.8% | 90.2% | 93.5% | 0.7795 |
BM25 기준과 비교하면 최종 조합의 Recall@5는 11.6%p 높았습니다. RRF로 후보 범위를 넓힌 뒤 재정렬을 적용해 상위 순위를 개선했고, 재정렬 전후 Top-20 Recall은 동일하게 유지됐습니다.
| 답변 평가 | 결과 | 조건 |
|---|---|---|
| Qwen Focused + Validation 정답 문자열 포함 | 55/100 | 노트북 고정 답변 표본 |
| Reader·Reader-First 정답 문자열 포함 | 74/100 | 같은 노트북 표본; 모든 최종 답은 Reader에서 선택 |
| 로컬 CLI 정답 문자열 포함 | 67/100 | 후보별 임계값·연도 검사 적용 |
| 로컬 CLI 답변 반환·보류 | 79 / 21 | 동일 100문항 |
| 반환한 답변 중 정답 문자열 포함 | 67/79, 84.8% | 전체 질문의 정확도와 다른 분모 |
| 수작업 무응답 점검에서 보류 | 5/6 | 알려진 실패를 포함한 작은 디버깅 표본 |
정답 포함은 정규화한 정답 문자열이 답변 안에 있는지 계산한 값입니다. 의미적 정확도와 같지 않으며, 인용 문맥에 답 문자열이 있다는 사실도 정답을 보장하지 않습니다. 노트북의 74%와 로컬 앱의 67%는 서로 다른 답변 정책의 결과입니다.
로컬 CUDA 평가에서는 모델 로딩 13.99초, 로딩을 제외한 평균 질의 시간 0.084초를 기록했습니다. 노트북의 Reader 답변 단계 0.031초는 Kaggle Tesla T4에서 검색·재정렬·모델 로딩을 제외한 값입니다. CLI는 실행할 때마다 모델을 다시 불러오므로 이 수치를 명령 시작부터의 전체 응답 시간으로 표기하지 않습니다.
Failure Analysis · 오류와 평가의 한계
노트북 100문항 중 정답 문자열을 포함한 답은 74개였습니다. 나머지는 답 근거를 검색했지만 Reader가 잘못 추출한 15개, 상위 3개 근거에서 정답을 찾지 못한 11개로 나눴습니다. 검색 후보를 개선하는 작업과 이미 찾은 문맥에서 답 구간을 고르는 작업이 서로 다른 문제임을 확인했습니다.
잘못된 질문 전제를 처리하는 한계도 남았습니다. 팬클럽의 ‘해체식’ 날짜를 묻는 질문에, 문맥에 있는 ‘창단식’ 날짜를 반환했습니다. 날씨·개인정보·미래 공연 등은 보류했지만, 관련 단어가 겹치는 잘못된 전제는 점수와 연도 검사만으로 잡아내기 어렵습니다. 무응답 5/6은 일반적인 범위 밖 질문 거절 성능으로 해석하지 않습니다.
3주차 Random Negative 기준 모델은 일부 검증 질문을 이미 학습한 상태였습니다. 따라서 기준 모델과 최종 모델의 차이를 Hard Negative 학습 효과의 독립적인 증거로 주장하지 않습니다. 최종 모델은 사전학습 가중치를 다시 불러와 학습했으며, 검색 순위 평가는 별도의 KorQuAD validation 질의에서 수행했습니다. 같은 질문 분할로 두 학습 방식을 통제 비교하는 과제는 남아 있습니다.
한 글자 답변을 인용 계산에서 제외하던 조건은 저장된 답변을 이용한 후처리로 수정했습니다. 답변 변경 없이 인용·근거 문자열 일치율이 97%에서 100%로 바뀌었으며, GPU 추론은 다시 수행하지 않았습니다. 원문 안의 잘못된 추출 답도 인용될 수 있어 인용률 100%를 정답률로 해석하지 않습니다.
지식베이스 범위, 입력 길이, 잘못된 전제와 문맥 추출 오류가 현재의 주요 제약입니다. 최신 정보 검색, 사용자 문서 업로드, 대화 이력은 지원하지 않습니다. 평가 기록의 코드 해시는 입력 검사와 예외 처리가 추가되기 전 실행 버전을 가리킵니다.
Demo · 실험 결과와 실행 방법
아래 자료는 노트북에 저장된 4주차 검색·재정렬 방식 비교 결과입니다. 현재 로컬 앱의 성격은 한국어 지식베이스를 조회하는 CLI입니다.
저장소의 안내에 따라 모델 출력물을 transformer/outputs 아래에 준비한 뒤, Python 3.12 환경에서 실행합니다.
python -m pip install -r requirements.txt
python -m korean_rag --question "방탄소년단의 팬클럽 창단식은 몇 월 며칠인가?"
저장된 검증 예시에서는 ‘2014년 3월 29일’과 방탄소년단 문맥의 청크 3167을 반환했습니다. --json은 구조화된 결과를, --no-reader는 답 추출 없이 검색·재정렬 근거만 제공합니다. --device cpu 또는 --device cuda로 실행 장치를 선택할 수 있습니다.
모델 체크포인트는 용량 때문에 GitHub에서 제외했으며 프로젝트 README에 다운로드 위치와 필요한 파일 구조를 정리했습니다. 첫 Reader 실행에는 공개 QA 모델 다운로드가 필요합니다.
Source Code · 코드와 검증 자료
GitHub 저장소에서 4주차까지의 학습 노트북과 로컬 앱 코드를 확인할 수 있습니다. 검색 방식·답변 정책·후처리의 차이는 4주차 결과 보고서에 정리했습니다.
실제 로컬 실행 환경, 입력 해시와 지표는 로컬 평가 매니페스트에 보존했습니다. 모델 없이 코드와 저장 결과를 확인하려면 python -m unittest discover -s tests -v를 사용하고, 실제 추론 평가를 다시 수행하려면 README의 평가 명령과 별도 결과 저장 경로를 사용합니다.